Leitfaden
Observability für agentische Workflows jenseits von Tracing
Ein grüner Trace heißt: die Pipeline ist gelaufen. Nicht: der Job war erfolgreich. Du brauchst trotzdem ein klares Produktziel und Belege auf demselben Lauf.
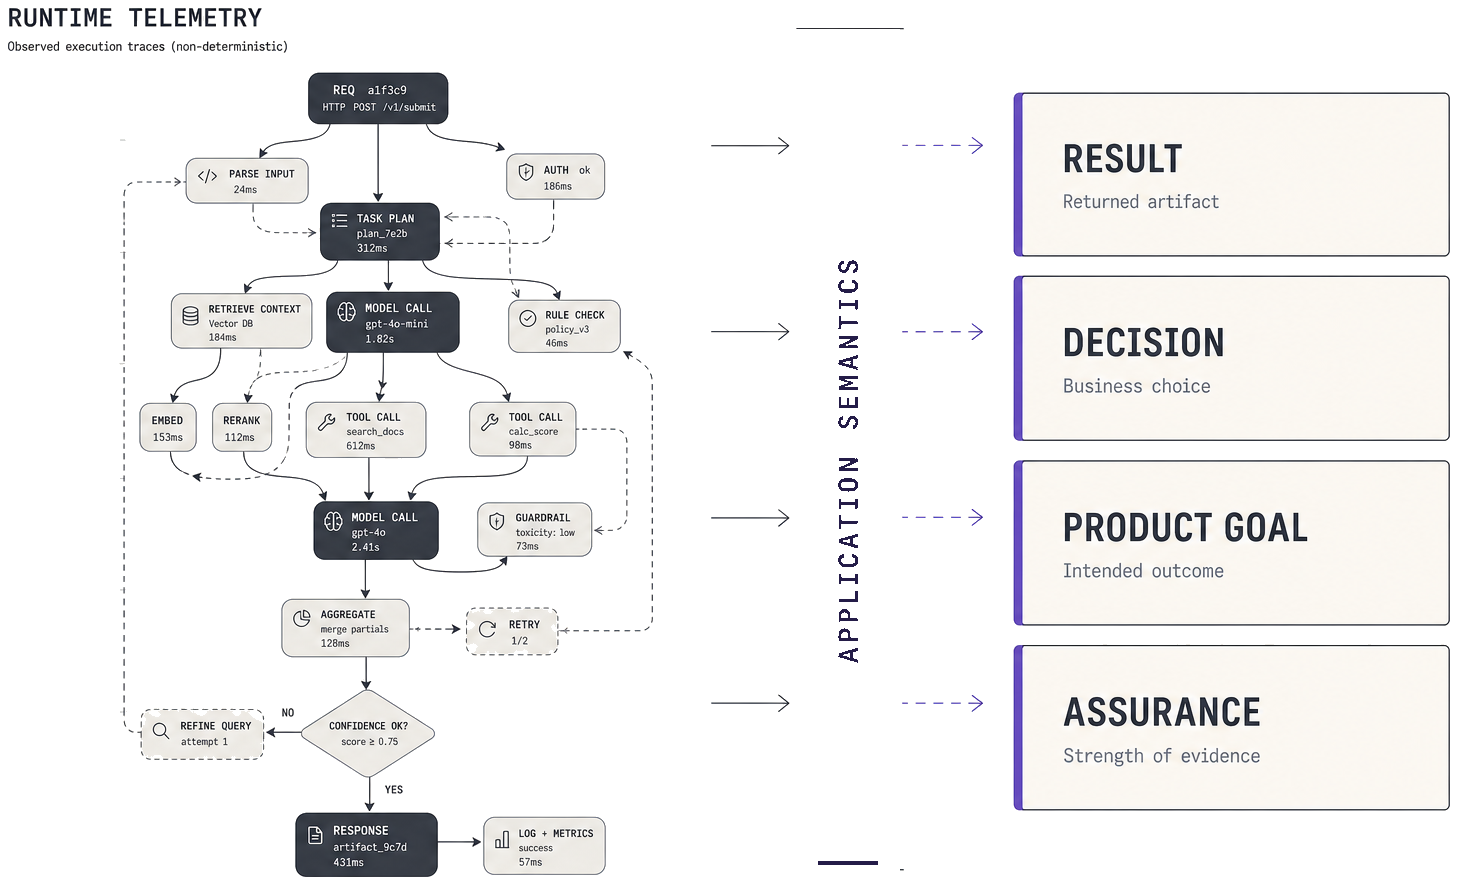
Vier Schichten
Observability für Agenten heißt: mehr sehen als Spans. Du willst wissen, was lief, wie gut es war, was es kostete und ob der Job erledigt ist. Diese vier Schichten stellen verschiedene Fragen an denselben Lauf.
Teams brauchen alle vier auf einem Lauf. Drei Tools und eine Tabelle sind nicht dasselbe. Liegen die Daten getrennt, rät man. Teilen sie eine Lauf-ID, kann man entscheiden.
Tracing
Was ist gelaufen? Spans, Tools, Modelle, Retries, Timing.
Evaluation
Qualität vs. Kriterien? Rubriken, Golden Sets, Online-Scores.
Kosten
Was hat es gekostet? Tokens und Tools auf demselben Lauf.
Produktziele
War der Job erledigt? Deklariertes Ziel + prüfbare Evidenz.
Was das in der Praxis heißt
Stell dir einen Agent-Lauf von Anfang bis Ende vor. Du betrachtest denselben Lauf auf vier Arten. Jede Schicht stellt eine einfache Frage.
Zuerst kommt Tracing: Du siehst, welche Schritte liefen, plus Tools, Modelle, Retries und Timing. Ein grüner Pfad sagt hier nur: „Der Code ist fertig.“
Dann kommt Evaluation. Du bewertest die Ausgabe anhand von Regeln, die du gewählt hast. Ein hoher Score braucht trotzdem einen Job, den du benannt hast.
Danach kommen die Kosten. Du hängst Tokens und Tool-Spend an denselben Lauf, denn Spend ohne Ziel ist nur eine Rechnung.
Zuletzt kommt das Produktziel. Du fragst: Haben wir das Ziel erreicht, das wir aufgeschrieben haben? Du behältst Felder, die das zeigen. Das ist die Schicht, die die meisten Stacks noch informell lassen.
Beispiel: falscher Erfolg
Pipelines können jeden Schritt abschließen und trotzdem den Produkt-Job verfehlen. HTTP 200 und fertige Spans sind nötig, aber allein reichen sie nicht.
Trace
Sieht gesund aus
- Retriever gelaufen
- LLM-Call fertig
- HTTP 200 OK
Alles wie geplant gelaufen.
Produktziel
Trotzdem verfehlt
Leere oder unbegründete Antwort
Runtime OK. Job nicht erledigt.
Das ist ein falscher Erfolg. Die Runtime sieht gut aus. Der Nutzer bekommt trotzdem eine leere oder unbegründete Antwort. Ops denkt vielleicht, das System ist gesund. Produkt weiß: Der Job ist fehlgeschlagen.
Ohne ein benanntes Ziel auf dem Lauf kannst du diese Fälle nicht trennen. Du siehst nur grüne Spans und verpasst den Fehlschlag, der für Nutzer zählt.
Ein Produktziel ist eine kurze, geteilte Regel. Sie sagt, was „fertig“ heißt. Evidenz sind die Felder, die Pass oder Fail für diesen Lauf belegen. Behalte beides neben dem Trace.
Dann kann ein Review fragen: Haben wir Geld für einen echten Erfolg ausgegeben? Oder haben wir für einen sauberen Fehlschlag bezahlt?
Anti-Patterns
Diese Abkürzungen sehen aus wie Monitoring. Sie lassen Outcomes weg. Jede beantwortet die falsche Frage. Grüne Spans allein reichen nicht. Ein einzelner Score reicht nicht. Spend ohne benannten Job erzeugt falsche Sicherheit.
Nur Tracing
Grüne Spans ohne deklariertes Produktziel.
Nur Score
Eval-Zahl ohne Job-Definition.
Kosten ohne Ziel
Spend ohne die Frage, was erreicht wurde.
Ändere die Gewohnheit, nicht nur das Chart. Benenne den Job. Hänge Belege an. Verbinde Kosten mit demselben Lauf.
Beispiel: Grounded-RAG-Contract
Ein kleiner Contract im Repo macht Erfolg leicht prüfbar. Du hältst die Regel neben der Pipeline. Du versteckst sie nicht nur hinter einem Dashboard-Schalter.
Das Beispiel unten nennt ein Artifact, eine Decision und ein Produktziel. Pass heißt: Die Antwort ist da und Grounding ist wahr. Diese Regel kann mit dem Code in Git liegen.
version: 1
service:
  name: grounded-rag
  runtime: haystack
contracts:
  grounded_answer:
    artifact:
      name: Grounded answer
      valid:
        non_empty: $.answer
    decision:
      name: Grounding decision
      expected: true
      observed: $.grounded
    product_goal:
      name: Successful grounded answer
      achieved:
        all:
          - $.witdem.artifact_valid
          - $.witdem.decision_correct
Was messen
Wenn du nur vier Gewohnheiten behältst, dann diese. Sie machen Pass und Fail später leicht erklärbar. Nutze dieselbe Definition im Repo. Behalte Belege auf dem Lauf. Kopple Kosten an dieses Outcome.
Ziel im Repo
Dieselbe Definition für alle.
Evidenz
Felder, die Pass/Fail am Lauf erklären.
Cost × Goal
Spend mit dem bewerteten Lauf verknüpft.
Kein stiller Judge
LLM-as-Judge benennen und versionieren.
Schreibe das Ziel einmal. Nutze es in Reviews. Erfinde in jedem Tool keine neue Bedeutung von „gut“.
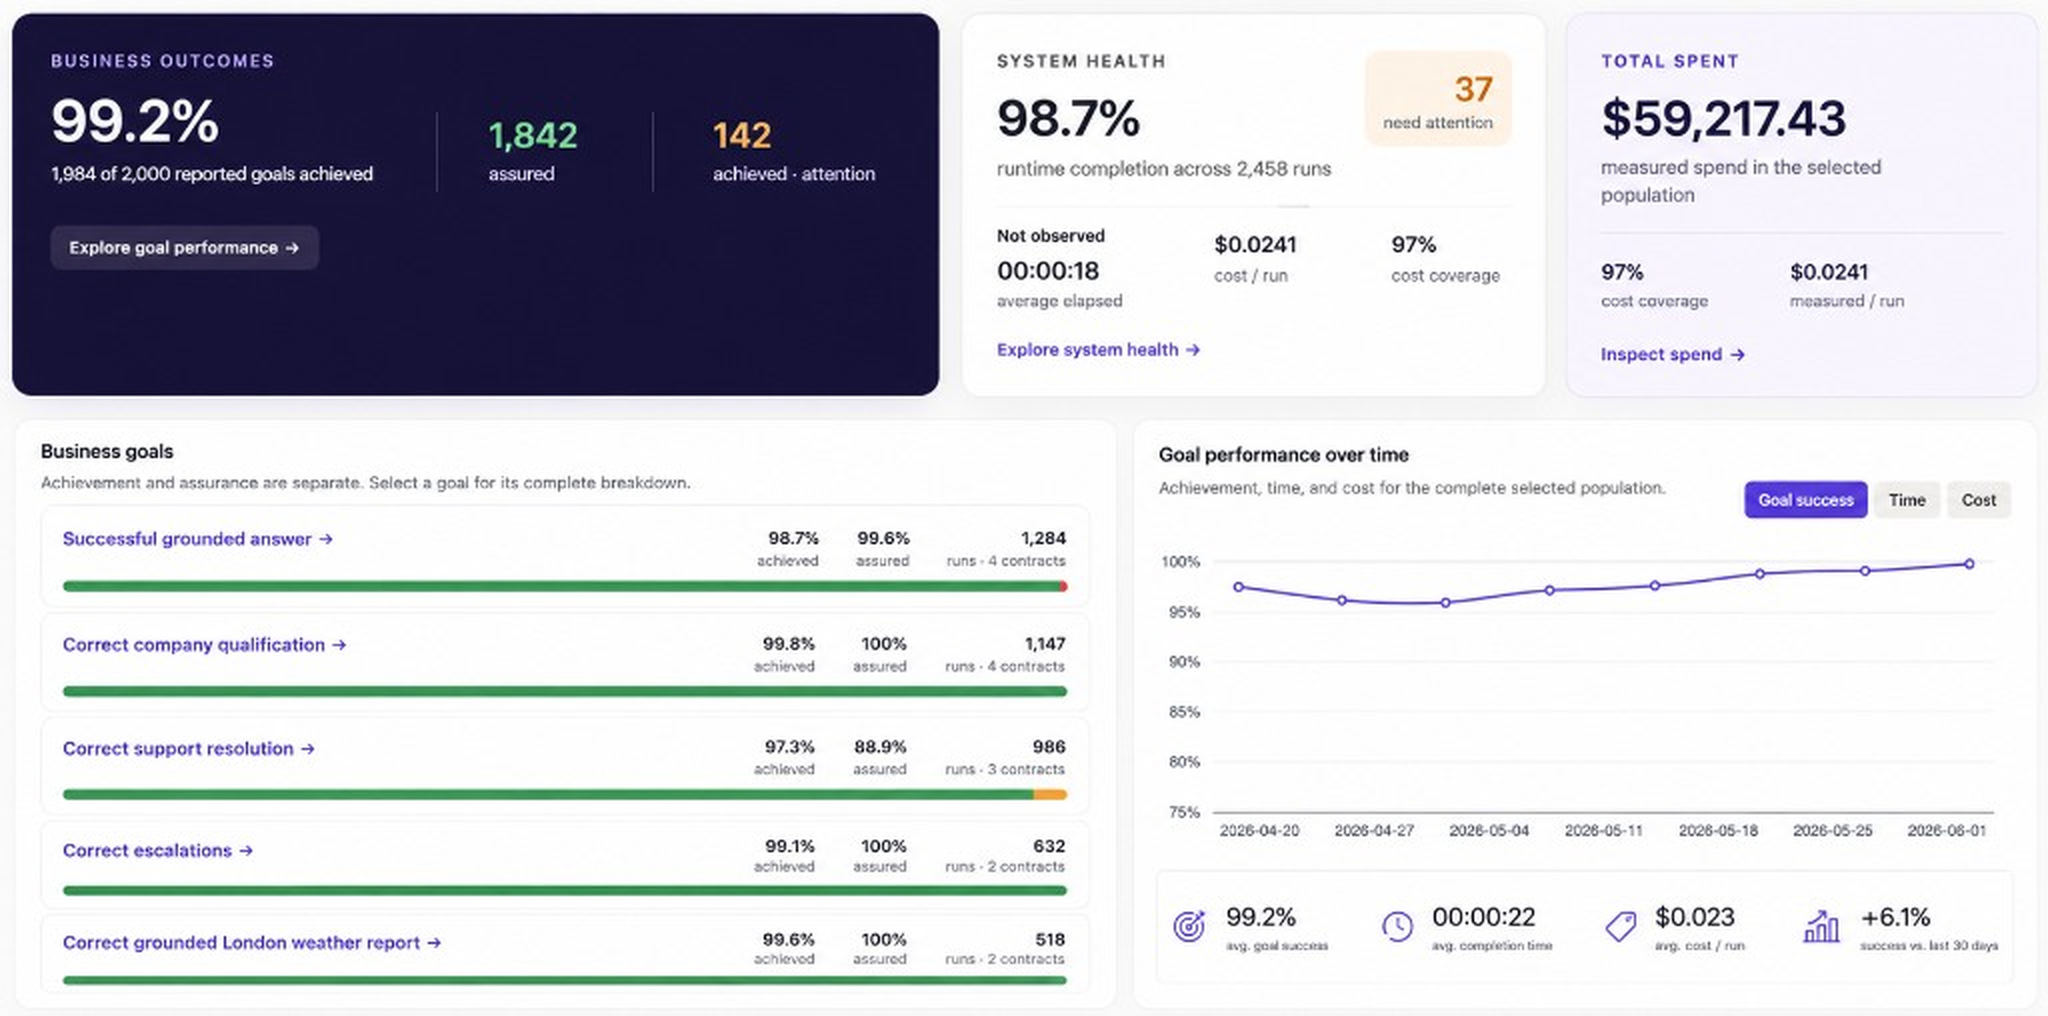
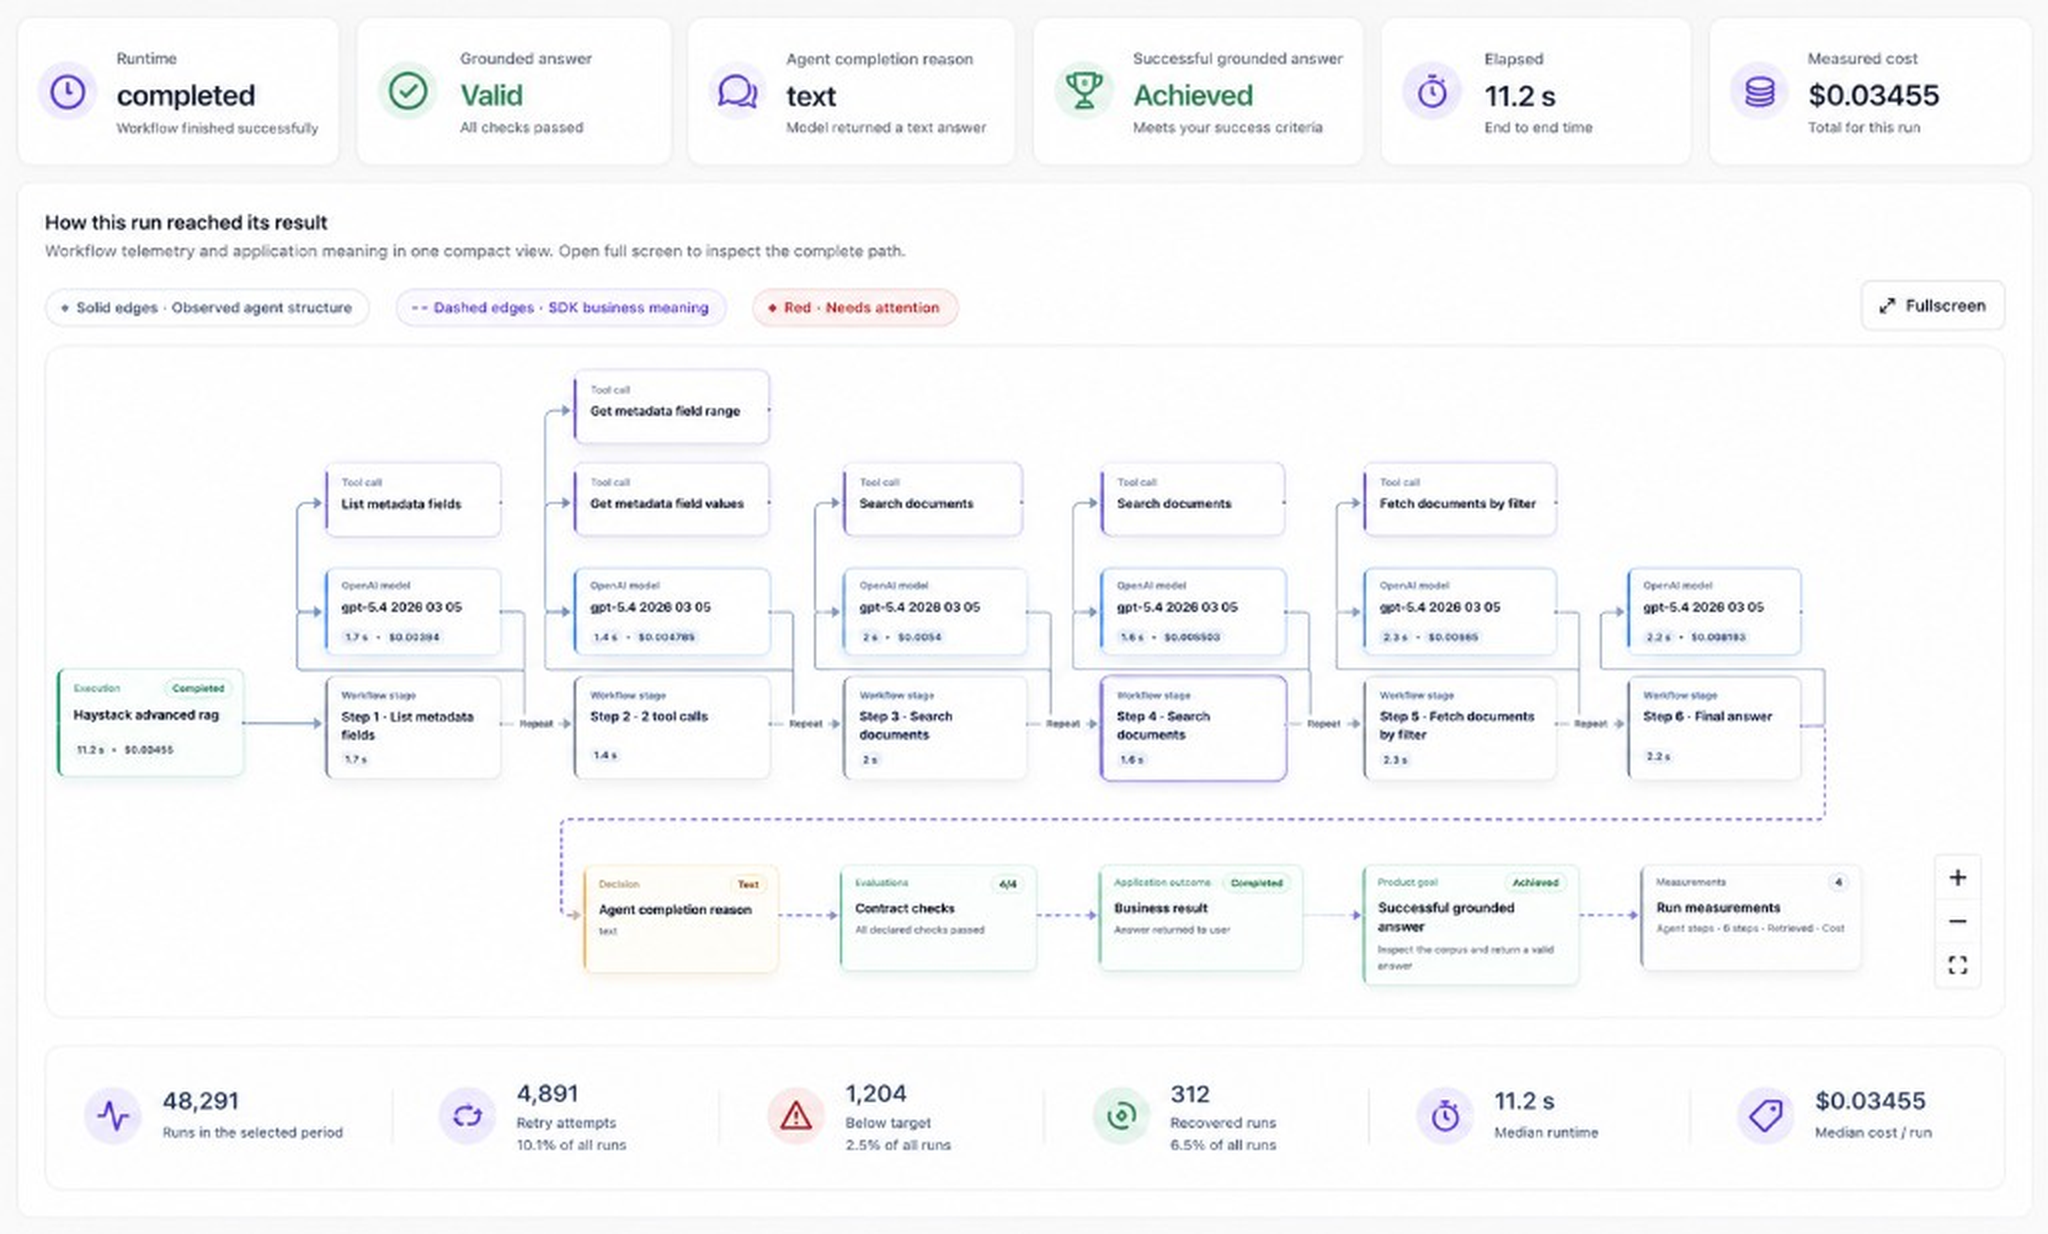
So sieht Outcome-Analytics aus
Dashboards helfen, wenn Ziel, Belege und Kosten dieselbe Lauf-ID teilen. Die Screens unten stammen aus Witdem. Das Muster zählt mehr als der Vendor.
Du willst einen Ort, der zeigt: Wurde das Ziel erreicht, warum, und zu welchem Spend? Path Replay hilft, wenn du die Schritte neben dieser Aussage brauchst.

Tool-Landschaft
Tracing-Tools sind stark. Evaluation-Tools sind ebenfalls stark. Outcomes mit Kosten auf demselben Lauf sind oft noch informell oder über Tabellen verteilt.
Die Lücke ist leicht zu nennen. Verbinde Outcome-Belege mit Spend auf demselben Lauf. Behalte Tracing und Eval. Ergänze den fehlenden Link.
Tracing
Langfuse · LangSmith · Phoenix
Evaluation
Braintrust und ähnliche
Outcomes + Cost×Goal
Oft noch informal oder getrennt
Hinweis zur Umsetzung
Das sitzt neben Tracing und Eval. Es ist kein Hard Sell. Contracts nennen das Ziel. Sie ersetzen deinen Stack nicht.
Witdem ist eine Option: Contracts in .witdem/witdem.yaml auf Haystack, LangGraph und ähnlichen Stacks. Kein Orchestrator. Ziel + Evidenz + Kosten neben Tracing und Eval — nicht statt dessen.
Starte mit einem benannten Ziel auf einem Flow. Hänge Beleg-Felder an. Prüfe Spend gegen dieses Ziel. Dann erweitern.
FAQ
Ist Tracing dasselbe wie Produktziele? Nein. Tracing zeigt, was gelaufen ist. Outcomes fragen, ob der Job, den du benannt hast, erledigt wurde. Du brauchst beides auf demselben Lauf.
Ersetzt ihr Langfuse oder ähnliche Tools? Nein. Behalte deinen Tracing-Stack. Ergänze ein klares Ziel und Belege daneben. Outcome-Analytics sitzt neben Tracing und Eval.
Was ist ein Produktziel? Eine kurze, geteilte Regel für „fertig“. Sie liegt im Repo. Evidenz sind die Felder, die Pass oder Fail für diesen Lauf zeigen.
Für wen ist das? Für Teams, die Agent-Workflows shippen und mehr brauchen als grüne Spans. Platform, ML und Produkt, die eine gemeinsame Definition von Erfolg teilen.
Framework-Leitfäden: Haystack · LangGraph · LangChain · OpenAI Agents · Case Study: Document Intake · Schichten: Tracing, Evaluation und Product Analytics · Nebeneinander: Langfuse · LangSmith · Phoenix